如果问人们“质量”意味着什么,得到的答案往往是一种体验:产品运行可靠、装配贴合、经久耐用。
但这种体验并非偶然。它来自设计、制造和检测环节数百项工程决策,而这些决策无一不建立在数据之上。
当企业优化质量成本(Cost of Quality)时,通常关注的是生产了“什么”以及“如何生产”:减少缺陷、收紧流程、改善设备。这些当然都很重要。
然而,支撑每一项质量决策的数据本身是否完整、准确,却很少受到同等严格的审视。现实情况是:检测结果需要人工转录;来自不同系统的数据采用不同格式;有些数据在源头采集时就出现了错误,而问题往往要到成本已经产生之后才暴露出来。
数据错误正在悄然累积
一次测量错误或一次错误标记的结果,很少只影响一个零件。它会进入SPC控制图和公差叠加分析,团队据此作出判断时,往往会产生超过数据本身可靠程度的信心。如果没有及时发现,这些错误还会进一步进入设计优化流程,并影响下一代产品版本。
一个可见的缺陷可能导致报废,或者促使相邻子系统进行调整;而一个不可见的数据错误,则可能持续产生影响,其成本甚至远远超过最初的错误本身。
质量成本中,失败成本通常占据主导地位,而数据质量会直接影响这一成本结构。不可靠的数据会增加出现意外不合格以及被动应急处理的可能性。检测数据确实存在,但我们对它有多大的信心?这是一个核心问题。
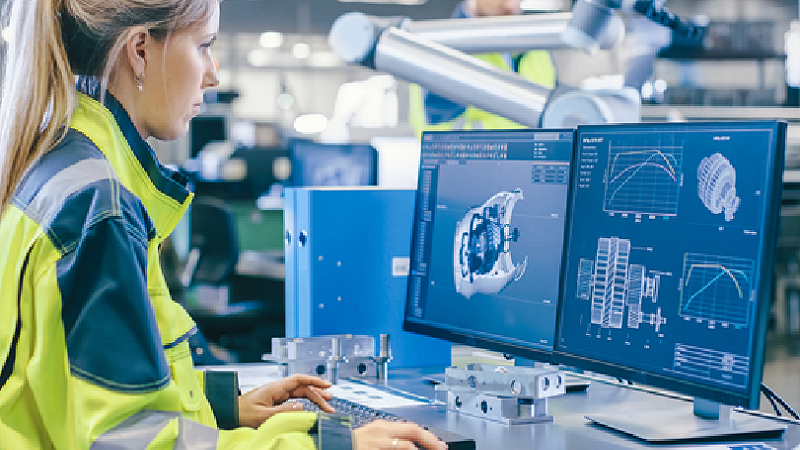
成本也不会止步于产品本身。每一家工厂都承担着一种已经被视为制造业常态的隐性成本:高技能工程师可能将高达80%的时间用于追踪、汇总和反复核对数据,而不是分析数据。它很少出现在质量成本报告中,却构成了一项可观的运营成本,而且每一个人工处理环节都会增加一次出错的机会。
对这些局限的认识又进一步放大了成本
当检测结果受到质疑时,企业会进行更多测量。当生产现场做出调整,却没有将结果反馈到产品生命周期管理系统中时,设计团队依据的假设就可能已经与实际情况不符;与此同时,人工变通方案又会推高销售成本(COGS)。制造价值链中的任何单一职能都无法获得完整视角,于是一个自我强化的循环逐渐形成:为了弥补那些我们无法完全信任的数据,进行更多人工检查,而这些检查又产生更多质量不确定的数据。
随着行业发展方向发生变化,这个恶性循环的影响会更加明显。随着基于模型的定义、数字孪生和AI辅助质量预测逐渐普及,数据质量已经从一个基础管理问题,变成了决定性因素。糟糕的输入数据不再只是产生糟糕的输出,它还会让自动化系统高效地、大规模地放大错误结论。
但反过来,机会同样巨大。设想一条统一的数字主线:数据在每一个环节都得到丰富,同时始终携带完成下一步工作所需的完整信息,从设计意图一直贯穿制造,再到质量验证。数据交接实现自动化,人工汇总消失。最终留给人的,是那些真正能够创造价值的工作:决策。
未来十年最具竞争力的制造商,不一定是拥有最多检测设备的企业,而是那些能够让质量决策建立在无需反复质疑的数据之上的企业。数据从CAD模型流向测量报告,整个过程不中断,只保留有意为之的人工干预。测量数据理应接受与产品本身同等严格的管理。在基于模型的制造世界里,两者已经密不可分。
因此,在启动下一项流程改进计划之前,不妨先问一个更简单的问题:我们对自己的数据有多大信心?这些数据在有人能够据此采取行动之前,究竟要经过多少双手?任何迟疑的地方,都可能成为改进的起点,也很可能成为企业最具成本效益的质量投资之一。
了解更多信息,请访问:www.metrologicdcs.com
作者:Karolina Rzepiejewska-Malyska,Metrologic DCS产品战略与创新副总裁